4-qism · Ma'lumotlar bilan ishlash·22-bob
Jupyter va scikit-learn: birinchi ML modelingiz
Jupyter bilan to'g'ri ishlash, ML ish jarayoni (workflow), train/test bo'linishi, baseline, Pipeline, metrikalar va confusion matrix, cross-validation, GridSearchCV, data leakage, matn tasnifi (TF-IDF) va modelni saqlash.
Shu paytgacha o'rgangan hamma narsa — Python, NumPy, Pandas, vizualizatsiya — shu bobda bitta maqsad uchun birlashadi: ma'lumotdan o'rganadigan model qurish. Biz scikit-learn'dan foydalanamiz — klassik ML'ning standart kutubxonasi. Bu bob ML nazariyasi kursi emas (u keyingi qadamingiz), balki Python muhandisi nuqtai nazaridan ML ish jarayonini to'g'ri qurish: qanday qilib o'zingizni aldamaslik, natijalarni takrorlanuvchan qilish va xatolardan qochish.
scikit-learn bo'yicha amaliy kurs: model, pipeline, GridSearchCV, metrikalar. Uzun — bobni o'qib, keyin kerakli qismlarini ko'ring.
1. Jupyter: tajriba muhiti#
Jupyter Notebook — kod, natija, grafik va matnni bitta hujjatda birlashtiruvchi muhit. Ma'lumotlarni o'rganish va tajribalar uchun ideal.
uv add --dev jupyterlab ipykernel
uv run jupyter lab
VS Code'da .ipynb faylni ochib, yuqori o'ng burchakda loyihaning .venv
kernelini tanlang — alohida server kerak emas.
Foydali "sehrli" buyruqlar#
%timeit np.sort(arr)              # kichik kodni ko'p marta o'lchash
%%time                            # butun hujayra vaqti (hujayraning birinchi qatori)
%load_ext autoreload
%autoreload 2                     # .py modullaringizdagi o'zgarishlar avtomatik qayta yuklansin
%matplotlib inline
!uv add scikit-learn              # terminal buyrug'i
df?                               # hujjat; df?? — manba kod
%autoreload 2 — eng muhimi: kodni .py modullarida yozib, notebook'da
faqat chaqirsangiz, modulni o'zgartirganingizda kernel'ni qayta ishga
tushirish shart bo'lmaydi.
Jupyter'ning yashirin xavfi: yashirin holat#
Hujayralarni istalgan tartibda ishlatish mumkin. Bu qulay, lekin xavfli:
[1] df = load()            ← 1-marta
[5] df = df[df.x > 0]      ← filtrlandi
[3] model.fit(df)          ← qaysi df? 3-hujayra 5-dan KEYIN ishlagan
[5] df = df[df.x > 0]      ← yana bir marta — endi ikki marta filtrlangan!
Notebook ekranda ko'rinadigan holat va xotiradagi haqiqiy holat farq qilishi mumkin. Qoidalar:
Muntazam 'Restart & Run All'
Notebook boshidan oxirigacha xatosiz ishlamasa — u natija emas, qoralama.O'zgaruvchini qayta yozmang
df = df[...]o'rnigadf_clean = df[...]— har bosqich o'z nomi bilan.Takrorlanuvchi kodni modulga chiqaring
Funksiyalarsrc/da, notebook'da — faqat chaqiruv va tahlil. Testlar modulga yoziladi (16-bob).Seed'larni boshida qotiring
rng = np.random.default_rng(42),random_state=42.Notebook'ni Git'ga toza qo'ying
Chiqishlarni tozalang (nbstripout) — aks holda diff'lar o'qib bo'lmas bo'ladi.
Notebook'lar — tajriba uchun. Production kodi — modullarda, testlar bilan.
2. ML ish jarayoni#
3. scikit-learn'ning yagona API'si#
scikit-learn'dagi har bir "estimator" bir xil interfeysga ega (12-bobda shu API'ni o'zimiz yozgan edik!):
| Metod | Nima qiladi | Kimda |
|---|---|---|
fit(X, y) | Ma'lumotdan o'rganadi, self qaytaradi | Hammasi |
predict(X) | Bashorat | Modellar |
predict_proba(X) | Sinflar ehtimoli | Klassifikatorlar |
transform(X) | Ma'lumotni o'zgartiradi | Preprocessorlar (scaler, vectorizer) |
fit_transform(X) | fit + transform | Preprocessorlar |
score(X, y) | Standart metrika | Modellar |
X — 2D jadval (n_samples, n_features) (NumPy massiv yoki DataFrame),
y — 1D javoblar (n_samples,). O'qitishda topilgan atributlar _ bilan
tugaydi: model.coef_, scaler.mean_.
4. Ma'lumot va bo'lish#
O'rnatilgan dataset — ko'krak bezi o'smalarini tasniflash (30 ta sonli xususiyat, 569 namuna):
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split

X, y = load_breast_cancer(return_X_y=True, as_frame=True)
X.shape, y.value_counts().to_dict()      # (569, 30), {1: 357, 0: 212}  — 1: xavfsiz, 0: xavfli

X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    stratify=y,            # sinflar nisbati ikkala qismda bir xil bo'lsin
    random_state=42,       # takrorlanuvchanlik
)
X_train.shape, X_test.shape # (455, 30), (114, 30)5. Baseline — "aqlsiz" model bilan boshlang#
from sklearn.dummy import DummyClassifier
from sklearn.metrics import accuracy_score

dummy = DummyClassifier(strategy="most_frequent").fit(X_train, y_train)
accuracy_score(y_test, dummy.predict(X_test))       # 0.632
Hech narsa o'rganmagan, doim "xavfsiz" deydigan model — 63% aniqlik. Demak "bizning model 85% aniq" — o'z-o'zidan hech narsa demaydi; baseline bilan solishtirish kerak. Nomutanosib datasetlarda (masalan, 99% oddiy, 1% firibgarlik) baseline 99% beradi — va accuracy umuman yaroqsiz metrikaga aylanadi.
6. Pipeline: preprocessing + model#
Logistik regressiya (LR) xususiyatlar bir xil shkalada bo'lishini yaxshi ko'radi (19-bobdagi z-score). Buni to'g'ri qilishning yagona to'g'ri yo'li — Pipeline:
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

pipe = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))
pipe.fit(X_train, y_train)        # scaler FAQAT train'ning o'rtacha/std'sini o'rganadi
pred = pipe.predict(X_test)       # test o'sha (train'dagi) parametrlar bilan o'zgartiriladi

accuracy_score(y_test, pred)      # 0.982
Scaler'siz xuddi shu LR — 0.965. Pipeline'ning qiymati faqat qulaylikda emas: u data leakagedan himoya qiladi (8-bo'lim).
7. Metrikalar: accuracy yetarli emas#
from sklearn.metrics import classification_report, confusion_matrix, roc_auc_score

print(classification_report(y_test, pred, target_names=["malignant", "benign"], digits=3))
precision recall f1-score support
malignant 0.976 0.976 0.976 42
benign 0.986 0.986 0.986 72
accuracy 0.982 114
macro avg 0.981 0.981 0.981 114
weighted avg 0.982 0.982 0.982 114from sklearn.metrics import ConfusionMatrixDisplay
ConfusionMatrixDisplay.from_predictions(y_test, pred, display_labels=["malignant", "benign"], cmap="Blues")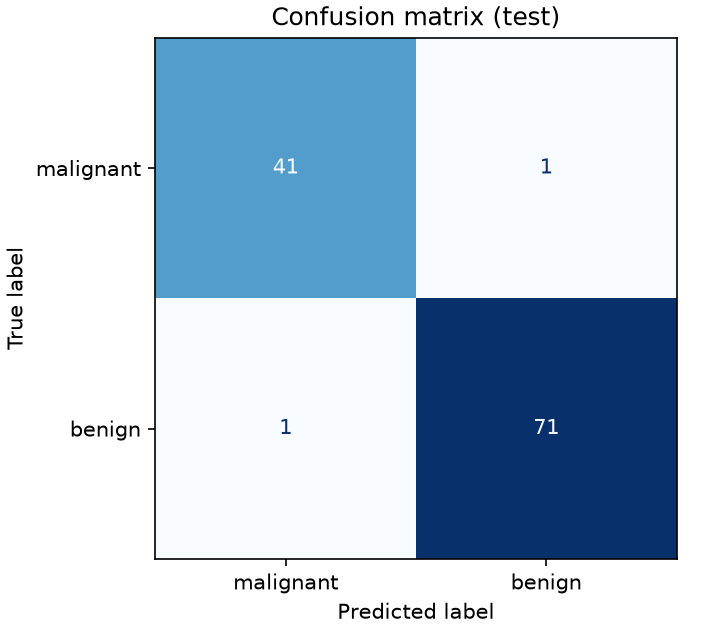
| Metrika | Savol | Formula |
|---|---|---|
| Accuracy | Hammasidan nechtasi to'g'ri? | (TP+TN) / hammasi |
| Precision | "Ha" deganlarimizning nechtasi haqiqatan "ha"? | TP / (TP+FP) |
| Recall | Haqiqiy "ha"larning nechtasini topdik? | TP / (TP+FN) |
| F1 | Precision va recall muvozanati | 2·P·R / (P+R) |
| ROC AUC | Ehtimollar bo'yicha tartiblash sifati (chegaradan mustaqil) | roc_auc_score(y, proba) |
Qaysi metrika muhim — masalaga bog'liq: bu misolda xavfli o'smani "xavfsiz" deb o'tkazib yuborish (confusion matrix'dagi 1 ta xato) — eng qimmat xato, shuning uchun "malignant" sinfi uchun recall asosiy metrika. Spam filtrda esa muhim xatni spamga tushirish yomonroq — u yerda precision muhim.
Ehtimollar va chegara#
proba = pipe.predict_proba(X_test)[:, 1]     # "benign" ehtimoli
roc_auc_score(y_test, proba)                 # 0.995

# Standart chegara 0.5. Xavfli holatlarni ko'proq ushlash uchun:
pred_cautious = (proba > 0.8).astype(int)    # "xavfsiz" deyish uchun ko'proq ishonch talab qilamiz
8. Data leakage — eng xavfli xato#
Data leakage — modelga o'qitish paytida test haqidagi ma'lumot "sizib" o'tishi. Natija: tajribada ajoyib raqamlar, real dunyoda — muvaffaqiyatsizlik. Eng ishonarli namoyish — sof shovqin ustida:
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.model_selection import cross_val_score

rng = np.random.default_rng(0)
X_noise = rng.normal(size=(200, 5000))     # 5000 ta tasodifiy "xususiyat"
y_noise = rng.integers(0, 2, 200)          # tasodifiy javoblar — o'rganadigan hech narsa YO'Q

# ❌ Xususiyatlarni BUTUN ma'lumot bo'yicha tanlab, keyin CV
X_selected = SelectKBest(f_classif, k=20).fit_transform(X_noise, y_noise)
cross_val_score(LogisticRegression(max_iter=1000), X_selected, y_noise, cv=5).mean()   # 0.795 (!)

# ✅ Tanlash pipeline ichida — har fold'da faqat train qismida
leak_free = make_pipeline(SelectKBest(f_classif, k=20), LogisticRegression(max_iter=1000))
cross_val_score(leak_free, X_noise, y_noise, cv=5).mean()                               # 0.51
Tasodifiy shovqinda 79.5% "aniqlik" — chunki xususiyatlar test qismlarini ham "ko'rib" tanlangan. To'g'ri usul tanga tashlash darajasini (51%) ko'rsatadi — haqiqat shu.
| Leakage turi | Misol | Himoya |
|---|---|---|
| Preprocessing butun datada | Scaler/imputer/feature selection testni ham ko'rgan | Hammasi Pipeline ichida |
| Vaqt bo'yicha | Kelajak ma'lumoti bilan o'tmishni bashorat qilish | Vaqt bo'yicha bo'lish (TimeSeriesSplit) |
| Guruh bo'yicha | Bir mijozning yozuvlari ham train, ham testda | GroupKFold, mijoz bo'yicha bo'lish (6-bob) |
| Javobdan kelib chiqqan xususiyat | "Qaytarilgan_summa" ustuni "qaytarildimi?" ni bashorat qilishda | Har bir xususiyat bashorat paytida mavjudmi — tekshiring |
| Dublikatlar | Bir xil matn train va testda | Bo'lishdan oldin dublikatlarni olib tashlang |
9. Cross-validation va giperparametrlarni sozlash#
Bitta train/validation bo'linishi tasodifga bog'liq. K-fold cross-validation — train'ni K qismga bo'lib, har biri navbat bilan validation bo'ladi:
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(pipe, X_train, y_train, cv=cv, scoring="accuracy")
scores              # [0.967 0.989 0.978 0.989 0.967]
scores.mean(), scores.std()     # (0.978, 0.0098)
Natijani har doim o'rtacha ± tarqoqlik bilan bering: "97.8% ± 1.0%". Ikki model farqi tarqoqlikdan kichik bo'lsa — ular amalda teng.
GridSearchCV#
from sklearn.model_selection import GridSearchCV

grid = GridSearchCV(
    make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)),
    param_grid={"logisticregression__C": [0.01, 0.1, 1, 10]},   # <qadam_nomi>__<parametr>
    cv=cv,
    scoring="f1",
)
grid.fit(X_train, y_train)
grid.best_params_          # {'logisticregression__C': 0.1}
grid.best_score_           # 0.986 — CV bo'yicha
grid.score(X_test, y_test) # 0.979 — testda, BIR MARTA
Bu 7-bobdagi itertools.product grid search'ning professional versiyasi:
har bir kombinatsiya uchun to'liq cross-validation, eng yaxshisi butun
train'da qayta o'qitiladi. Katta grid uchun RandomizedSearchCV yoki
Optuna.
Boshqa model sinab ko'rish#
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier(n_estimators=300, random_state=42, n_jobs=-1).fit(X_train, y_train)
accuracy_score(y_test, rf.predict(X_test))       # 0.947

sorted(zip(rf.feature_importances_, X.columns), reverse=True)[:3]
# [(0.137, 'worst perimeter'), (0.137, 'worst area'), (0.116, 'worst concave points')]
Murakkabroq model har doim yaxshiroq emas: bu datasetda oddiy, to'g'ri shkalalangan LR random forest'dan yaxshiroq. Avval sodda model, keyin murakkablik — faqat o'lchov ko'rsatsa.
10. Matn tasnifi: TF-IDF + LR#
LLM'lardan oldin matn tasnifi shunday qilingan — va bugun ham kichik, tez, arzon baseline sifatida juda foydali:
from sklearn.feature_extraction.text import TfidfVectorizer

texts = [
    "mahsulot juda zo'r, tez yetkazib berishdi", "sifati a'lo, hammaga tavsiya qilaman",
    "narxiga arziydi, juda mamnunman", "ajoyib xizmat, rahmat",
    "zo'r telefon, batareyasi uzoq ishlaydi", "kuryer xushmuomala, hammasi joyida",
    "juda yoqdi, yana buyurtma beraman", "sifatli va chiroyli",
    "umuman yoqmadi, pulimni qaytaring", "yetkazib berish juda kech keldi",
    "sifati yomon, bir haftada buzildi", "rasmdagidan butunlay boshqacha",
    "xizmat yomon, javob berishmadi", "qutisi yirtilgan, mahsulot singan",
    "narxi qimmat, sifati past", "hech kimga tavsiya qilmayman",
]
labels = ["pos"] * 8 + ["neg"] * 8

UZ_TOKEN = r"(?u)\b\w[\w']*\w\b|\b\w\b"     # o'zbekcha apostrofli so'zlarni bo'lmaslik uchun

clf = make_pipeline(
    TfidfVectorizer(token_pattern=UZ_TOKEN, ngram_range=(1, 2), sublinear_tf=True),
    LogisticRegression(C=10),
)
clf.fit(texts, labels)
clf.predict(["juda zo'r xizmat, rahmat", "sifati yomon va kech keldi"]) # ['pos', 'neg']16 ta misol — albatta o'yinchoq. Real loyihada minglab belgilangan misollar kerak; ularni yaratishning zamonaviy usuli — LLM bilan belgilash (17-bobdagi parallel tasnif!) va keyin kichik, tez modelni o'qitish ("distillatsiya"). Yoki aksincha: TF-IDF baseline'ni LLM bilan solishtirib, qimmat LLM chaqiruvi o'zini oqlaydimi — o'lchash.
11. Modelni saqlash va yuklash#
import joblib

joblib.dump(pipe, "model.joblib")        # butun pipeline: scaler + model
loaded = joblib.load("model.joblib")
loaded.predict(X_test[:3])12. Amaliyot: to'liq, takrorlanuvchan o'qitish skripti#
"""train.py — modelni o'qitadi, baholaydi va artefaktlarni saqlaydi."""

import json
from datetime import datetime, timezone
from pathlib import Path

import joblib
import sklearn
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, roc_auc_score
from sklearn.model_selection import GridSearchCV, StratifiedKFold, train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

SEED = 42
OUT = Path("artifacts")


def main() -> None:
    X, y = load_breast_cancer(return_X_y=True, as_frame=True)
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=SEED)

    search = GridSearchCV(
        make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000)),
        {"logisticregression__C": [0.01, 0.1, 1, 10]},
        cv=StratifiedKFold(5, shuffle=True, random_state=SEED),
        scoring="f1",
    ).fit(X_train, y_train)

    model = search.best_estimator_
    proba = model.predict_proba(X_test)[:, 1]
    report = classification_report(y_test, model.predict(X_test), output_dict=True)

    OUT.mkdir(exist_ok=True)
    joblib.dump(model, OUT / "model.joblib")
    meta = {
        "created": datetime.now(timezone.utc).isoformat(),
        "sklearn": sklearn.__version__,
        "seed": SEED,
        "best_params": search.best_params_,
        "cv_f1": round(search.best_score_, 4),
        "test_accuracy": round(report["accuracy"], 4),
        "test_roc_auc": round(float(roc_auc_score(y_test, proba)), 4),
        "features": list(X.columns),
    }
    (OUT / "meta.json").write_text(json.dumps(meta, indent=2, ensure_ascii=False), encoding="utf-8")
    print(json.dumps({k: meta[k] for k in ("best_params", "cv_f1", "test_accuracy", "test_roc_auc")}))


if __name__ == "__main__":
    main()
{"best_params": {"logisticregression__C": 0.1}, "cv_f1": 0.9861, "test_accuracy": 0.9737, "test_roc_auc": 0.9957}Seed'lar qotirilgan, test bir marta ishlatilgan, model + metama'lumot
birga saqlangan, versiyalar yozilgan. Olti oydan keyin "bu model qanday
yaratilgan edi?" savoliga meta.json javob beradi.
Nima noto'g'ri ketishi mumkin#
| Xato | Oqibat | Tuzatish |
|---|---|---|
| Testga qarab modelni sozlash | Optimistik, yolg'on natija | Sozlash — CV bilan train ichida; test — bir marta |
Scaler/selector butun datada fit | Data leakage | Pipeline |
| Baseline yo'q | "85%" ning ma'nosi noma'lum | DummyClassifier bilan boshlang |
| Nomutanosib datada accuracy | Chalg'ituvchi baho | Precision/recall/F1, PR AUC |
stratify yo'q | Kichik sinf test'da kam/yo'q | stratify=y |
random_state yo'q | Har ishga tushirishda boshqa natija | Seed'larni qotiring |
| Bitta CV natijasi | Tasodifiy farqni "yutuq" deb o'ylash | O'rtacha ± std |
| Notebook yashirin holati | Takrorlab bo'lmaydigan natija | Restart & Run All |
| Begona joblib/pickle yuklash | Kod bajarilishi xavfi | Faqat o'zingiznikini |
| O'zbekcha matn standart tokenizer bilan | Apostrofli so'zlar buziladi | token_pattern, normalizatsiya |
1. To'liq ish jarayoni
sklearn.datasets.load_wine (3 sinfli) uchun bu bobdagi butun jarayonni
takrorlang: bo'lish (stratify), baseline, pipeline, 5-fold CV (o'rtacha ±
std), GridSearchCV, testda yakuniy baho, confusion matrix grafigi. Qaysi
sinflar ko'proq chalkashtiriladi?
Maslahatni ko'rsatish
load_wine (3 sinf); DummyClassifier; Pipeline(StandardScaler, LogisticRegression); GridSearchCV C bo'yicha; classification_report; ConfusionMatrixDisplay.
2. Leakage'ni o'zingiz toping
20-bobdagi orders.csv dan "reyting ≥ 4 bo'ladimi?" degan tasniflash
masalasini tuzing. Avval ataylab xato yo'l bilan qiling: rating NaN'larini
butun data mediana bilan to'ldiring, revenue / city_mean_revenue xususiyatini
butun datadan hisoblang. Keyin hammasini Pipeline + ColumnTransformer
ichiga ko'chiring. Natijalar farqini tushuntiring. (Bu sun'iy datasetda
reyting tasodifiy — to'g'ri natija baseline'ga yaqin bo'lishi kerak!)
Maslahatni ko'rsatish
SimpleImputer'ni pipeline ichiga qo'ying; ColumnTransformer bilan sonli va kategoriyali ustunlarni alohida qayta ishlang.
3. Chegarani tanlash
Breast cancer modeli uchun precision_recall_curve chizing va "malignant"
sinfi uchun recall ≥ 99% bo'ladigan chegarani toping. Bu chegarada
precision qancha? Bunday chegarani testda emas, validationda
tanlash kerakligini hisobga oling.
Maslahatni ko'rsatish
precision_recall_curve(y_test, proba) → precision, recall, thresholds; recall >= 0.99 bo'lgan eng katta threshold.
4. TF-IDF va LLM solishtirmasi
O'zingiz 100 ta o'zbekcha sharh yozing (yoki LLM bilan yarating va qo'lda tekshiring), 70/30 bo'ling. TF-IDF + LR ni o'qiting. Keyin 23-bobni o'qib bo'lgach, xuddi shu test qismini Claude bilan tasniflang va aniqlik, narx, kechikishni jadvalda solishtiring (20-bob amaliyoti).
- 01Jupyter — tajriba uchun: autoreload, Restart & Run All, kodni modullarga chiqaring.
- 02Ish jarayoni: masala va metrika → EDA → bo'lish → baseline → pipeline → CV → test bir marta.
- 03scikit-learn API: fit / predict / predict_proba / transform; X — 2D, y — 1D.
- 04Har doim baseline (DummyClassifier) bilan solishtiring.
- 05Pipeline preprocessing'ni modelga bog'laydi va data leakage'dan himoya qiladi.
- 06Accuracy'dan tashqari: precision, recall, F1, ROC AUC, confusion matrix — masalaga mosini tanlang.
- 07Cross-validation natijasi — o'rtacha ± std; GridSearchCV — train ichida sozlash.
- 08Model + metama'lumot + versiyalar birga saqlansin; joblib — faqat ishonchli fayllar.
Mustahkamlash
Test va amaliy masalalar
Avval testni ishlang — har javobdan keyin izoh chiqadi. Keyin masalalarni shu yerning o'zida yechib, brauzerdagi haqiqiy Python bilan avtomatik tekshiring. Natijalaringiz kurs progressi sahifasida jamlanadi.
Bilimni tekshirish
Bob bo'yicha test
12 ta savol · har javobdan keyin to'g'ri yoki xatoligi va izoh ko'rsatiladi · oxirida natija foizda.
Amaliy masalalar
Kodni yozing va «Tekshirish»ni bosing (yoki Ctrl/⌘ + Enter). Kodingiz shu brauzerda saqlanib turadi.
01To'g'ri pipeline
build_model() — StandardScaler + LogisticRegression(max_iter=1000) pipeline'ini qaytarsin. evaluate(X, y, seed=42) — train_test_split(test_size=0.2, stratify=y, random_state=seed), pipeline'ni train'da o'qitib, test accuracy'ni qaytarsin.
02Cross-validation hisoboti
cv_report(model, X, y, k=5) — StratifiedKFold(k, shuffle=True, random_state=0) bilan cross_val_score qilib, (o'rtacha, std) ni 3 xona yaxlitlab qaytarsin.
03Confusion matrix va metrikalar
report(y_true, y_pred) — {"cm": [[TN, FP], [FN, TP]], "precision": ..., "recall": ...} qaytarsin (sklearn'ning confusion_matrix, precision_score, recall_score; cm — Python ro'yxatlari, metrikalar 3 xona).